模型选择与积分
看懂倍率,按活选模型,同样的活少花好几倍积分
- 看懂模型列表后面的倍率,知道快速、均衡、极致三档各用在什么活上
- 选“够用就好”的模型:简单活用便宜的,难活再升档,Auto 不是总划算
- 一次说清、对话别拖长、压缩或开新任务时带一份交接说明
- 会查自己的用量;定时跑的活,先估一笔月账
常能听到这样的抱怨:就做了一个记账任务,2000 积分就用完了。
记账不是什么难活,积分是花在了别处:最贵的往往不是某一次调用,而是方向没说清、模型没选对、对话越拖越长,最后让 AI 反复重做。
拿一个写代码的任务对照一下就清楚:不讲究的用法,来回聊十几轮;一次把需求说清、话说简洁、中途压缩对话,几轮就做完。两种用法花掉的积分,能差出好几倍。
WorkBuddy 里几乎每一次对话都要花积分,花多少,看两件事:用的是哪个模型,这件活有多复杂。这一节讲怎么把积分花在刀刃上。
看懂模型列表
点输入框下方显示的模型名,打开模型列表,能看到一串模型,每个后面跟着一个数字,比如 0.29x、0.65x、1.20x。
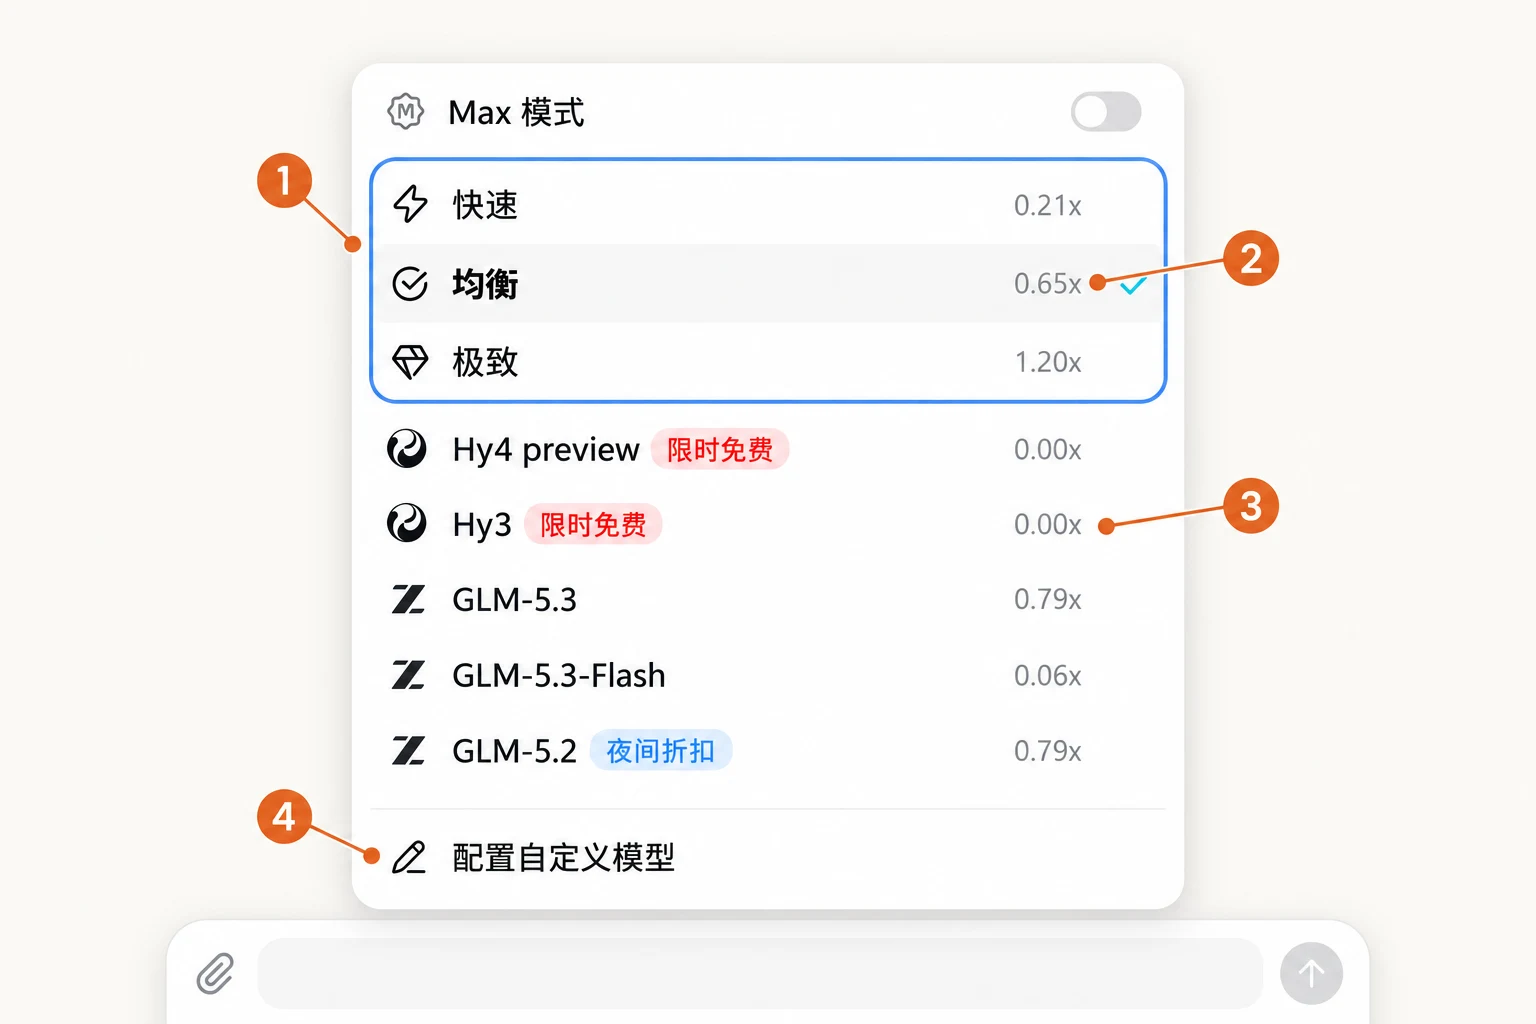
这个数字不是价格,是倍率。说白了:1.00x 是基准线,数字越小越省;同一件活,用倍率高的模型,扣的积分就按倍数往上走。9 月的客户端列表里,是这样一串:
| A | B | C | |
|---|---|---|---|
| 1 | 模型 | 倍率 | 说明 |
| 2 | Hy3 | 0.00x | 当时限时免费 |
| 3 | DeepSeek-V4.1-Flash | 0.03x | 当时的独家优惠 |
| 4 | GLM-5.3-Flash | 0.06x | |
| 5 | Hy4 preview | 0.29x | |
| 6 | 均衡档 | 0.65x | |
| 7 | GLM-5.3 系列 | 0.79x | |
| 8 | 极致档 | 1.20x | |
| 9 | Kimi-K3 | 1.62x |
最便宜的 0.03x 对最贵的 1.62x,倍率差了五十多倍。实际扣多少,还要看这件活用了多少,但方向很清楚:模型那一行选错,成本能差出好几倍甚至几十倍。
三档模式:拿不准就用均衡
模型列表最上面的三档,是官方替你打包好的选择:
| 模式 | 适合什么活 | 特点 |
|---|---|---|
| 快速 | 简单明确的活:起几个标题、改一小段文字、格式转换 | 响应最快;具体扣多少,看所选模型的倍率 |
| 均衡 | 大多数活:写文档、整理表格、分析数据、改多个文件 | 效果和速度都顾上,拿不准时选它 |
| 极致 | 复杂的活:步骤多、要反复推理和验证的分析 | 慢一些,贵一些,但复杂的活做得更稳 |
举几个例子:给文章起 5 个标题,用快速;把一堆文件按日期归类,用均衡;分析一份销售数据找出下滑原因,用极致。
这里有个隐蔽的坑:模型选“自动”(Auto)时,它会自己挑模型,挑的有时是倍率偏高的那个。公道地说,Auto 的价值是自动挑,它不等于浪费;可要是一件简单的小活、你又在乎积分,就手动选一个便宜的。
选“够用就好”的那个
省积分,不是永远选最便宜的。原则就一句:选能把这件活一次做对的、最便宜的那个模型。太弱的模型做不好,来回返工,反而更贵。
按活分档,大致是这样:
| 你的活 | 选什么 |
|---|---|
| 改写、润色、总结、分类、转格式、简单表格 | 快速档,或列表里倍率低、又能胜任的模型 |
| 写报告、做 PPT、分析数据、整理一批文件 | 均衡档 |
| 很长的资料:整本书、几百页的报告 | 支持超长上下文的模型(模型介绍里写着能读很长的内容) |
| 要看图、处理图片 | 能看图的模型(手机小程序里是带“视觉”标签的) |
| 步骤多、结论很重要、错了代价大 | 极致档或高倍率的模型 |
还有一个叫 Max 模式 的开关。它会关掉对话的自动压缩,让模型一直记着所有内容,适合很复杂的长任务,但也更费积分。一般的活不用开。有句口诀好记:心里没底开 Plan,查东西开 Ask,复杂长任务开 Max。
上下文窗口是另一档,跟 Max 不是一个开关。默认的够绝大多数活用。拉到最长不会让它更聪明,只是每一轮都把整段前文再送一遍,积分成倍往上走。真要读超长的文档,或者这场对话必须把前面的内容整段记住,再调大。
省积分,靠这几个习惯
一次说清
需求说不清,它就猜,猜错了再改,改一轮扣一轮。所以省积分的头一条就是一次说清,说全四个要素:背景(我要做什么、为什么)、目标(最终交付什么)、约束(要求、风格限制)、格式(Word、Excel、PPT 还是别的)。这和第 6 节讲的是一回事。
还有几招很实在:
- 限制输出长度:“只要结论,不要解释过程”“列出 3 条就行”“不超过 200 字”。
- 同类的活一次交:五段话要翻译,别开五次对话,一次全贴上去。
- 直接要文件:别让它在对话框里吐一大段让你复制,直接说“生成一个 Word 文件”。
复杂的活,先让它交计划,你点头再动手。想清楚再做,比做完推倒重来便宜得多。可以直接用这段:
先不要直接执行,请先为这个任务制定计划。请确认:1. 最终目标是什么;2. 允许操作和不允许操作的范围;3. 需要使用哪些文件、工具和数据;4. 最终应该交付什么;5. 如何验证完成,以及有哪些风险。计划给我确认后,再开始执行。
对话别拖太长
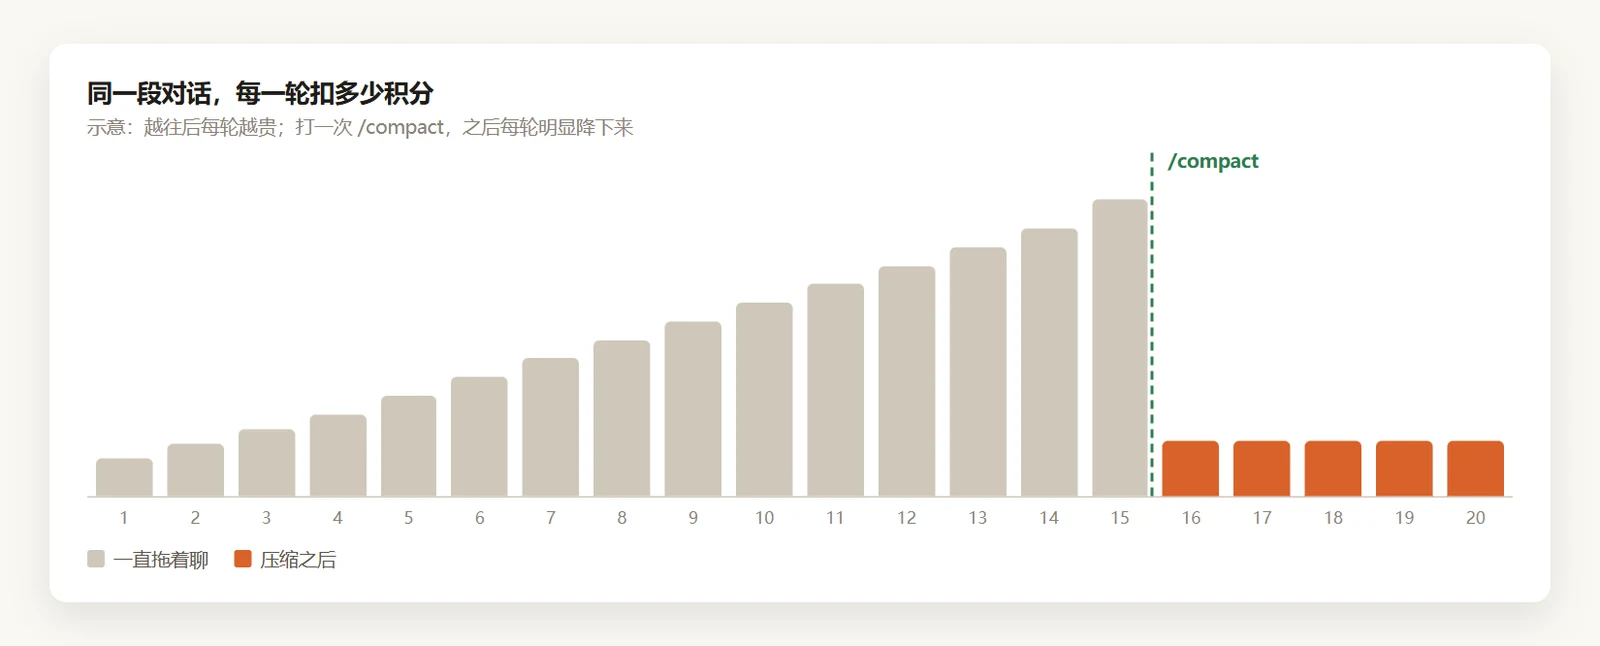
对话越长,每一轮要带着的前文越多,扣得越多,聊到第 20 轮,一轮的消耗可能是第 1 轮的好几倍。所以一个阶段做完了,就新建一个任务,把真正需要的背景写成几句话带过去。交接说明可以这样写:
- 当前目标我现在要完成什么
- 已确认的决定前面已经定下哪些选择,不要重复讨论
- 必须使用哪些文件、数据、风格或规则必须继承
- 当前进度已完成什么,还剩什么
- 验收标准最终怎么判断是否完成
我现在要完成什么
前面已经定下哪些选择,不要重复讨论
哪些文件、数据、风格或规则必须继承
已完成什么,还剩什么
最终怎么判断是否完成
不想新开,就压缩一下
在输入框里打 /compact,它会把前面的对话压缩成摘要再接着聊。拿一段十几轮的写代码对话来说,压缩以后,后面每一轮的消耗能降到原来的几分之一。省多少每次不一样,但对话越长,压缩越值。
看看钱花在哪了
点左下角的头像,进个人中心,找到用量那一栏,能看到每个任务扣了多少积分。有个实在的办法:挑同一件小活,在同一天分别用两个模型各跑一次,对一下明细,差多少一眼就看出来了。
常见的活大概花多少,有个量级就行:
| 什么活 | 大致消耗 |
|---|---|
| 简单问答 | 10 到 30 积分 |
| 邮件翻译 | 30 到 50 积分 |
| 行业日报 | 约 50 积分 |
| 文档整理 | 约 100 积分 |
| 深度调研报告 | 300 到 800 积分,最费 |
这只是个大概,模型、倍率一变就不一样,以你的用量明细为准。
每天、每周都要跑的活(第 27 节讲的定时任务),尤其要先算一笔账。有个很好用的式子:
单次消耗 × 每天几次 × 一个月几天 = 一个月的消耗
例:一个每日资讯简报,单次约 50 积分: 50 × 1 × 30 = 1500 积分 / 月
太费就降频:每天一次改成每周一次,消耗直接降到七分之一。
还要知道一点:个人套餐的月度积分按月发放,当月有效、不结转到下个月;送的积分、加量包各有各的有效期。攒着不用,到期就清零。
进阶:接入你自己的模型
如果你已经买了某家大模型服务的套餐,拿到了可用的密钥(API Key),可以在模型列表最下面「配置自定义模型」里接进来。
需要准备接口地址(通常以 /v1 结尾)、API Key、模型名称三样;目前只认兼容 OpenAI 协议的接口。实际配下来,DeepSeek 用得很顺,某些旗舰模型的接口就可能对话不了。用厂商自己的套餐接进来,计费就发生在厂商那边。
密钥相当于账户的钥匙,别发到群里、别截图外传。这一步需要一点动手能力,没这个需要可以跳过。
看一眼你的模型列表和用量
- 打开模型列表,找到三档模式,看看你常用的模型倍率是多少,Auto 开没开。
- 挑一件小活,分别用快速档和均衡档各做一次,去用量里对比扣了多少。
- 下次一个任务聊得很长时,试一次新建任务(带上交接说明)或
/compact。 - 如果有每天都要跑的活,用上面的式子估一笔月账。
到这里,第五章讲完了:技能给它手艺,专家给它眼光,选对模型让它又好又省。下一章,我们让它更懂你:记住你的习惯,用上你的资料。