文件审阅与核对
合同、报告、几份材料,读出要点、揪出前后矛盾
- 先问它读到了几份、几页,扫描件和跨页表格先抽检再全量
- 把“可核验”写进指令:页码、表名、单位,原文没有就写“无法确认”
- 长文件分段读,钱、日期、续约、解约这几类点名追问
- 几份材料放在一起,让它交回一张差异表,你只判断哪边对
在制造业做财务分析的人,每年年报季都要回答同一类问题:同行几家公司,谁的收入增长更有质量,利润有没有现金流撑着,应收账款和存货谁最该警惕。今年,三家白色家电公司的年报交给了 WorkBuddy,其中一份有 276 页。
第一次,它跑了二十多分钟,交回一份结构完整、每个数都标了页码的分析。看着能用,可一核对就头疼:每个数字都得翻回 PDF,确认是哪张表、哪一年、单位是千元还是万元。
第二次,同一份年报、同一段指令、同一个模型,只加了一个文档解析的连接器,三分钟左右就跑完,还多交回一份“解析文件”,每张表的结构和页码都保住了。抽查了两张最复杂的表,数字一个没串行,才放心往下做三家的比较。
这节课讲的就是这件事:让它读文件,最怕的不是它读不懂,而是它没读全、没读清,还一本正经地给你结论。就像有人把一叠材料拿回来,说一句“都看过了,没什么问题”,你分不清是真看完了,还是只翻了前几页。后面那份 6 页的采购合同就是这样:它只读到了第 1 页,所以几乎没查出风险。它说没问题,可能只是没读到。怎么让它读全、读对,让每条结论都能翻回原文,是这一节的主菜。
一次完整的审阅:三份年报变成一张能核对的表
先把整个过程走一遍。这个案例用的是上市公司年报,你手上可能是合同、制度、招标文件、检测报告,做法是通的。
- 美的集团 2025 年年度报告.pdf
- 海尔智家 2025 年年度报告.pdf
- 格力电器 2025 年年度报告.pdf
动手之前,先定了一条验收标准:每个数字都要能回溯到原文的页码、表名和单位。做不到这一点的财报分析,核对不了,也就没法用。后面的指令,就是照着这条标准写的:
请仅依据上传的 2025 年年度报告,分析公司的收入、净利润、毛利率、经营活动现金流、应收账款、存货和主要业务板块变化。先列出关键数据及同比变化,再解释变化原因,最后总结经营亮点、潜在风险和需要进一步核验的问题。所有数字注明原文页码、表名和单位;报告中没有明确依据的内容请标注“无法确认”。
这段话里有三处是专门为“能核对”写的:“仅依据上传的年报”,不许它拿记忆补;“注明页码、表名和单位”,每个数都能翻回去;“没有明确依据的标注无法确认”,给它一个不编的出口。
(上传 276 页年报,发上面那段指令)
它在干活 · 3 步
- 读取 PDF,提取文字
- 找到营业收入、净利润、现金流等数据
- 计算同比,写分析
(先到连接器市场里搜“文档解析”,挑一个接上,再在输入框旁的“+”里打开它,同一段指令再跑一次)
它在干活 · 2 步
- 调用解析连接器,把 PDF 解析成保留表格结构和页码标记的文件
- 在解析结果上做分析
第二次没有改指令,也没有换模型,因为问题不在“分析”,在更前面的“读”:几百页的年报,表格的结构、页码、单位如果在读的时候没理清,后面分析写得再流畅,核对起来也处处要翻原文。补上一个专门解析文档的连接器,地基就正了。连接器是什么、怎么装,第 25 节细讲;这里记住一个道理就够:又长又复杂的文件,先让它“读好”,再让它“分析”。
拿到结果没有先看结论,而是先抽查:打开原始 PDF 和解析文件,挑了两张结构最复杂、又和分析直接相关的表对照。
| 抽查的表 | 难在哪 | 核对结果 |
|---|---|---|
| 第 49 页“营业成本构成” | 行业和项目两层行、两个年度的金额和占比、最右边还有同比 | 年份、金额、占比都对在正确的列上,没有串行 |
| 第 53 页“资产构成重大变动情况” | 两级表头,一行里放着期末、期初、占比变化和文字说明 | 各归各列;解析文件里还留着“第 53 页”的标记,随时能翻回去 |
两张表核对无误,才把同一套做法扩展到三家公司,用的是第二段指令:
请仅依据已上传的美的集团、海尔智家和格力电器 2025 年年度报告,建立一张可核验的横向比较表。金额统一为亿元;每个指标同时列出 2025 年数值、2024 年数值、同比变化、单位、公司、报告印刷页码和表名。请把报告直接披露的同比与根据两个年度数值计算的同比分开标注。分别回答:哪家公司的利润增长更快、哪家的经营现金流相对利润更充足、哪家的应收账款或存货变化最值得关注。无法从原文确认的原因请明确标注,不要补写原文没有的解释。
交回的比较表,每一行都长这样(示意,数字略去):
| A | B | C | D | E | F | G | H | I | |
|---|---|---|---|---|---|---|---|---|---|
| 1 | 指标 | 公司 | 2025 年 | 2024 年 | 同比 | 同比口径 | 单位 | 页码 | 表名 |
| 2 | 应收账款 | 美的集团 | …… | …… | …… | 计算所得 | 亿元 | 第 … 页 | 合并资产负债表 |
| 3 | 应收账款 | 海尔智家 | …… | …… | …… | 报告披露 | 亿元 | 第 … 页 | …… |
| 4 | 应收账款 | 格力电器 | …… | …… | …… | 计算所得 | 亿元 | 第 … 页 | …… |
三家的核对,专挑了“硬骨头”:一张表里金额、比率、倍数混在一起的,和一张被 PDF 分页切成上下两段的长表。结果百分比、倍数、金额各归各列,跨页的表也接成了一张,“合计”行落在正确的位置。
这个案例能总结出四条,照搬到任何长文件上都成立:
- 先读好,再分析。 几百页、多级表头、跨页长表的文件,别直接让它分析。
- 把“能核对”写进指令。 页码、表名、单位;分清原文写的和它算的;允许它说“无法确认”。这三条,比“请深入分析”有用得多。
- 抽查以后再信结论。 挑两张最复杂的表对照原文,结构对了,后面的分析才值得看。
- 你的时间花在判断上。 定验收标准、抽查、解释为什么利润涨了现金流没跟上,这些是你的事;提取、整理、横向比较,交给它。
第一件事:问它读到了什么
年报那个案例遇到的是“读得不够清楚”,核对成本高。还有一种更糟的情况:它根本没读到,结论却照样给你。
有个合同审查助手,是用 WorkBuddy 接上腾讯云的文字识别做的,拿一份 6 页的采购合同来试。那是一份扫描件,每页都是图片。结果交回来,几乎没查出风险。回头一看才发现,识别脚本只识别了第 1 页,后面五页根本没读,自然什么风险都“看不见”。改成逐页识别后,同一份合同查出了好几项风险,多数是高风险。
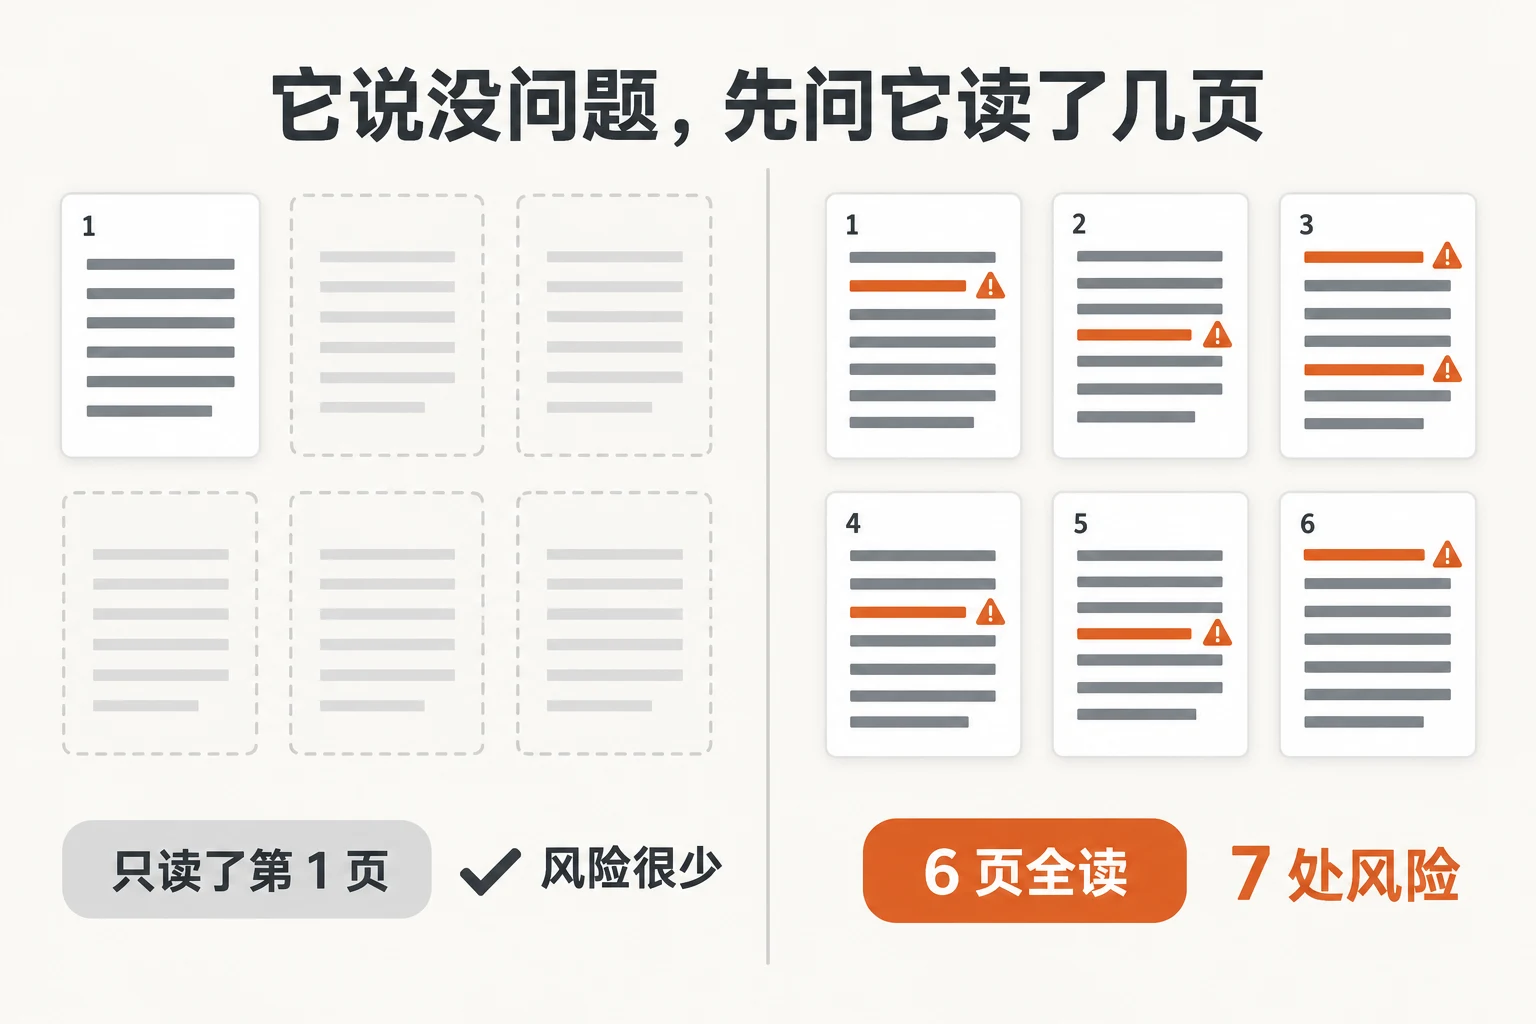
所以交给它一份合同、一堆材料,先别急着要结论,先问一句:
先告诉我:你读到了几份文件、每份多少页,有没有哪一页是图片、识别不出文字的。先别下结论。
它报回来的页数和你手上的对不上,就是漏读了。
还有一种漏法是版本。一堆材料里有好几个版本,你得告诉它哪份是最新的。比如三个版本的报价单一起丢进去,你不说,它大概率不会抓最新的。
扫描件、拍照件:先抽检,再全量
扫描件和手机拍的文件,是最容易读错的。做汽车零部件测试的,经常要把几十份扫描版检测报告里的表格抽成 Excel。第一次只说了一句“把这份 PDF 的表格抽出来”,结果翻了两处车:
- 表格的标题行被当成数据塞进了表体;
- 跨了两页的同一张表,被拆成上下两张,列数对不上,后面几家的数据全错位了。
还有一次,一份手机拍照转成的 PDF,小数点印得浅,它把“3.2”读成了“32”,单位“mA”也被当成数据填进了列里。
后来抽表,就固定用这样一段指令:
- 输入已上传【文件名】,目标表格在第【3】页,标题含【振动与噪声测试结果】
- 任务提取该表,输出 Excel
- 表头表头原样保留在第一张表顶部,只抽数据行
- 跨页跨页的同一张表合并为一张,不要拆成两张
- 单位和数值单位单独标注,不混进数据单元格;数值保留原始小数位,不要四舍五入
- 看不清的模糊、缺字、表格线断裂的单元格标黄,在表后列出来
已上传【文件名】,目标表格在第【3】页,标题含【振动与噪声测试结果】
提取该表,输出 Excel
表头原样保留在第一张表顶部,只抽数据行
跨页的同一张表合并为一张,不要拆成两张
单位单独标注,不混进数据单元格;数值保留原始小数位,不要四舍五入
模糊、缺字、表格线断裂的单元格标黄,在表后列出来
最后再加一句“输出 Excel,再加 3 行文字说明你做了哪些识别和校正”。拿到表以后,扫一眼这 3 行说明,随机抽两三行和原文件对一遍小数位和单位,再下载。这一步花不了一分钟,却能挡掉大部分抽表事故。
几十份一起抽的时候,先别全量。让它先出前 15 行给你看,小数位和单位对了再放开。这条后来写进了团队的规矩:凡是扫描件,一律先抽检再全量。
早年还出过一件事:让助理手抄 8 家供应商的检测报告做对比,其中一家的数据抄错了一位小数,整组对比结论反了,差点把合格的供应商淘汰掉。人抄会错,AI 读也会错;差别在于,让它读的时候,你可以要求它把拿不准的地方标出来。
让每条结论都能回到原文
读全了、读对了,再要结论。要的时候,把结论的样子交代清楚。审合同、审报告,可以把要求写成这样四句:
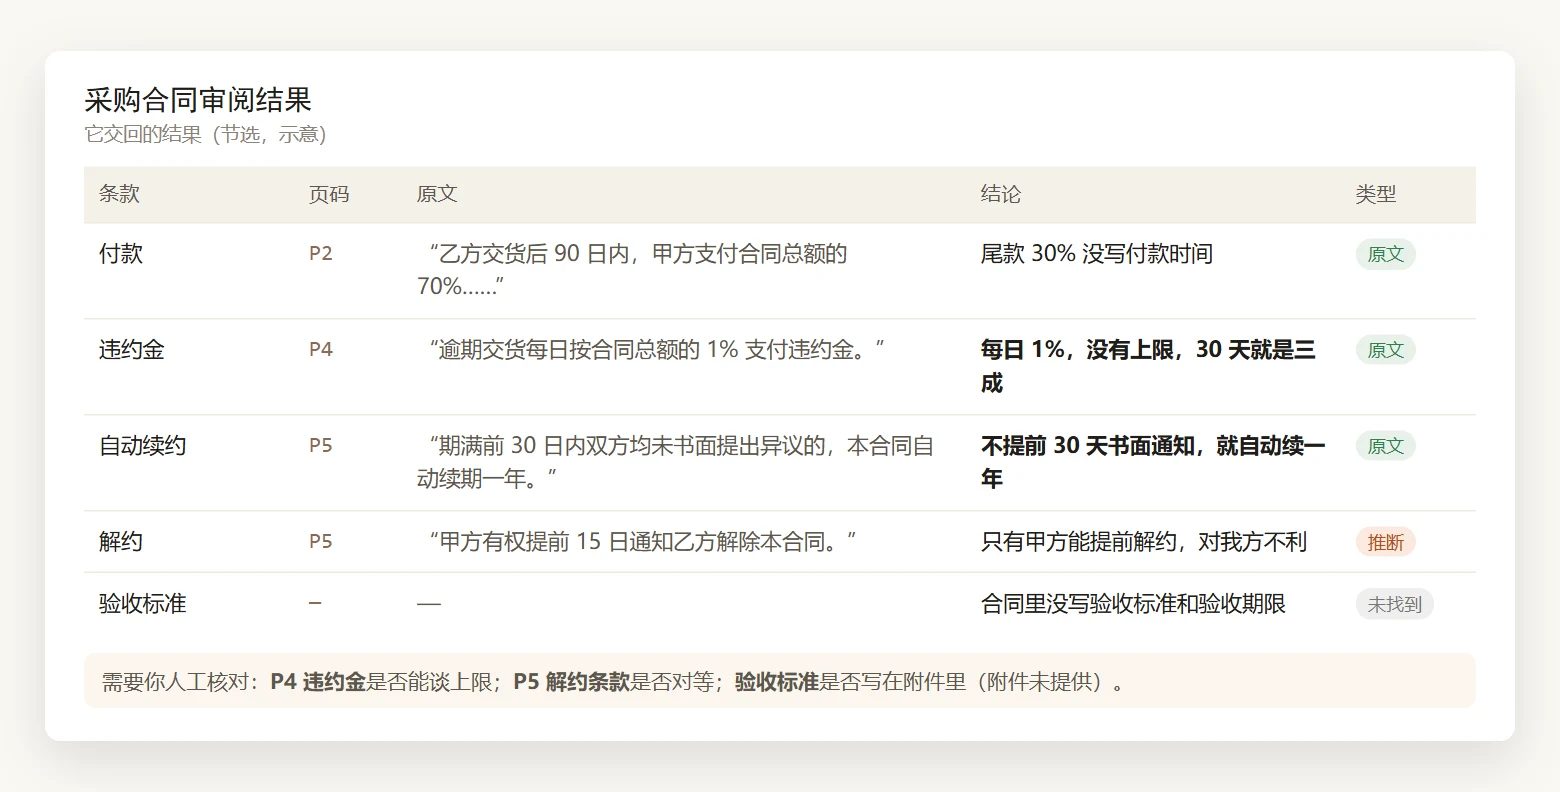
帮我审一下这份合同,重点看付款、违约、续约、解约、保密这几类条款。每条结论后面写上页码,附上对应的原文。原文里写的,和你自己的推断,分开标出来。原文里找不到的,直接写“未找到”,不要补全。最后单独列出需要我人工核对的地方。
把合同、报告丢给 AI,最怕的不是它漏一段,而是它把自己的推测,写得像原文结论。有了页码和原文,每一条你都能翻回去对;标着“推断”的,你知道那是它的看法。
它交回来的,大概是这个样子:
交回来以后,还可以追一句,让它自己查自己:
只检查刚才没有出处、或者出处撑不起结论的句子,逐条改正。
网页、没有页码的文档怎么办?可以让它标“小标题 + 原文开头 10 个字”,一样能找回去。
长文件分段读,点名问“钱”
有人让 AI 总结一份 30 页的合同,它漏了第 7 页的违约金。还有人用 GPT-4o 审合同,它把“违约金上限”“保密期限”都标成了重点,偏偏漏了最要命的“自动续约条款”。
漏了违约金那次,后来的办法很朴素:长文件分三段给它,每段多问一句:
这一段里,有没有跟钱有关的?付款时间、金额、违约金、扣款、自动续费,逐条列出来,带页码。
钱、日期、自动续约、单方解约,这几类最容易出事,也最容易被一笔带过。点名问,它才会一条条去翻。
WorkBuddy 官方的上手技巧里也是这个思路。反面例子是一句话把活全甩给它:“帮我把这份 50 页的行业报告读一遍,写一份内部汇报 PPT 发给领导的邮箱。”正面例子是拆成几轮,第一轮只做一件事:
读取 D:/报告/2026年AI行业报告.pdf,提炼 5 个最核心的结论,每个结论用一句话概括,并附带原文页码。
你看过这 5 条、确认它读对了,再让它写汇报。
几份材料放一起,让它找矛盾
一个人看五六份材料,很难发现 Word 里写的和 Excel 里写的不一样。这正是它的强项。
比如接到老板的活,要核对 6 个文件。在微信里给 WorkBuddy 派活时,交代里有这么三句:“读取这个工作目录的全部文件。”“不要修改任何原文件。”“无法确定的内容不要自行判断,单独标记出来。”补上要什么,就是这样一段话:
读取这个工作目录的全部文件。不要修改任何原文件。找出各个文件之间对不上的地方,整理成一张差异表。无法确定的内容不要自行判断,单独标记出来。
它交回一张差异表,其中一条是:“张三——金额冲突,人员统计.xlsx:5000,上报材料.docx:4800”。6 个文件,自己一个字都没看,对不上的地方已经摆在眼前。
| A | B | C | D | E | F | |
|---|---|---|---|---|---|---|
| 1 | 对象 | 问题 | 文件一 | 写的是 | 文件二 | 写的是 |
| 2 | 张三 | 金额冲突 | 人员统计.xlsx | 5000 | 上报材料.docx | 4800 |
| 3 | 李四 | 日期不一致 | 考勤汇总.xlsx | 3 月 12 日 | 出差审批单.pdf | 3 月 13 日 |
| 4 | 王五 | 无法确定 | 人员统计.xlsx | 部门:市场部 | 上报材料.docx | 未写部门 |
差异表把“哪个文件、写的什么”摆在一起,你只需要判断哪边是对的。这一招换到不同岗位上:
合同和报价单对一对,最常见的坑在金额和付款方式。
这两份文件是同一个项目的报价单和合同。逐项对比:产品型号、数量、单价、总价、付款方式和时间、交货期、质保期。只列出两份不一致的地方,每条写清两边原文和页码。不要改动文件。
员工来问制度,让它照员工手册回答,而且引原文。把员工手册、考勤制度全放进知识库,用的就是这个办法,为的是杜绝 AI 瞎编制度。资料库怎么建,第 24 节讲。
基于员工手册,回复员工提出的这个问题:年假能不能跨年清零。给出可以直接发给员工的回复,引用制度原文,写明在第几章第几条。手册里没写的,直接告诉我“手册未规定”,不要推测。
制度、方案改了新版,看清到底改了哪几处。
「差旅制度-旧版.docx」和「差旅制度-新版.docx」逐条对比。列一张表:条款位置、旧版原文、新版原文、改动类型(新增 / 删除 / 修改)。只列有变化的,措辞微调但意思没变的单独放在最后。
加盟、合作之前,把对方给的材料放在一起查前后矛盾,相当于做一次加盟风险体检:招商 PPT、合同、收益测算表、微信聊天记录一起喂进去,专找说法对不上的地方。
这几份是加盟品牌给我的材料:招商 PPT、加盟合同、收益测算表、我和招商经理的聊天记录。找出前后说法不一致的地方,特别是加盟费能不能退、保证金、装修费用、回本周期、区域保护。每条写清哪份材料、原文怎么说。
它审完,还得你来拍板
一份 40 页的合同,逐条看少说也要一两个小时;交给 WorkBuddy 的合同审查专家,常见的标准合同,大部分常见风险都能抓到。但再准,也只是初筛。
让它起草法律文书更是这样,比如协商解除协议:它写出来的只能当草稿,涉及解除、补偿的,一定要人工二次审核,最好咨询公司法务后再定稿。
它帮你找出来、标清楚;签不签、改不改、找不找法务,是你的事。专家怎么用,第 21 节会讲。
找两份你手上内容有重叠的文件,交给它
- 先问它读到了几份、每份几页,和你手上的对一对。
- 是扫描件的话,先让它抽前几行给你看,再全量。
- 让它每条结论带页码和原文,找不到的写“未找到”。
- 让它列出两份文件对不上的地方,挑一条翻回原文核对。
资料查到了、文件读透了。下一节换一种材料:不是写好的文件,而是一场会上大家说的话,怎么变成纪要、待办和需求文档。