幻觉识别与来源核查
最容易编造的内容、降低编造的问法、回到原文核实
- 知道 AI 最容易在哪几类内容上编,拿到回答先看哪几处
- 用几句话让它少编:允许说不知道、分清事实和推测、标出把握
- 回到原文核实,而不是问同一个 AI"你确定吗"
- 按错了的后果,决定这一次要核多细
两边律师都用了编出来的判例
一场官司,原告和被告的律师都用 AI 写了递交法院的文书,里面都引用了根本不存在的判例。两边谁也没发现,直到法院发出通知,要求两边解释。
听证会上,律师们都道了歉。法院的命令里写着:起草文书的律师,提交前都没有核实 AI 给出的法律依据。在文书上签了名的其他律师也一起受了罚:交出去的东西,签名的人就要负责,不管是不是自己用的 AI。其中一位律师说,自己已经这样用了六个月,从来没核对过,"不知道什么是幻觉判例"。法院认为这个解释不充分、也不可信。
结果是每人罚款 1000 到 3500 美元,有人被取消在当地出庭的资格两年。
这不是个例。一家全球知名的咨询公司给一国政府写的一份报告,合同金额约 44 万澳元,被一位大学研究者发现里面引用了不存在的学术论文,还有一段法官判决里根本没有的"原话"。修订版删掉了这些引用,公司退还了合同的最后一笔款。
这些都是专业人士,都有时间核对,也都没核。
离普通人更近的一件:一家航空公司网站上的客服机器人告诉乘客,丧亲优惠票可以先按原价买,事后再申请退差价;航空公司自己的规定却是必须在出发前申请。乘客照着机器人的话做,被拒了退款,告上法庭,法庭判航空公司为机器人的说法负责。机器人讲错的,是一条直接关系到钱的规定;核它的办法很简单:打开官方的规定页面看一眼。
你身边也天天有小一号的版本:转到家族群的"研究表明"、孩子作业里抄来的"名人名言"、帮你算的一笔账,都可能是这样来的。
第 1 节讲过:它记不清的时候,常常不会停下来说"我不确定",而是接着写一个最像的。这一节讲三件事:它最容易在哪编、怎么问能让它少编、拿到回答怎么核。
编出来的,和真的长得一模一样
AI 编的参考文献,有标题、有作者、有期刊名、有年份,格式和真的完全一样。它不是故意骗你,它只是按"一条参考文献通常长这样"写出了最像的一条。
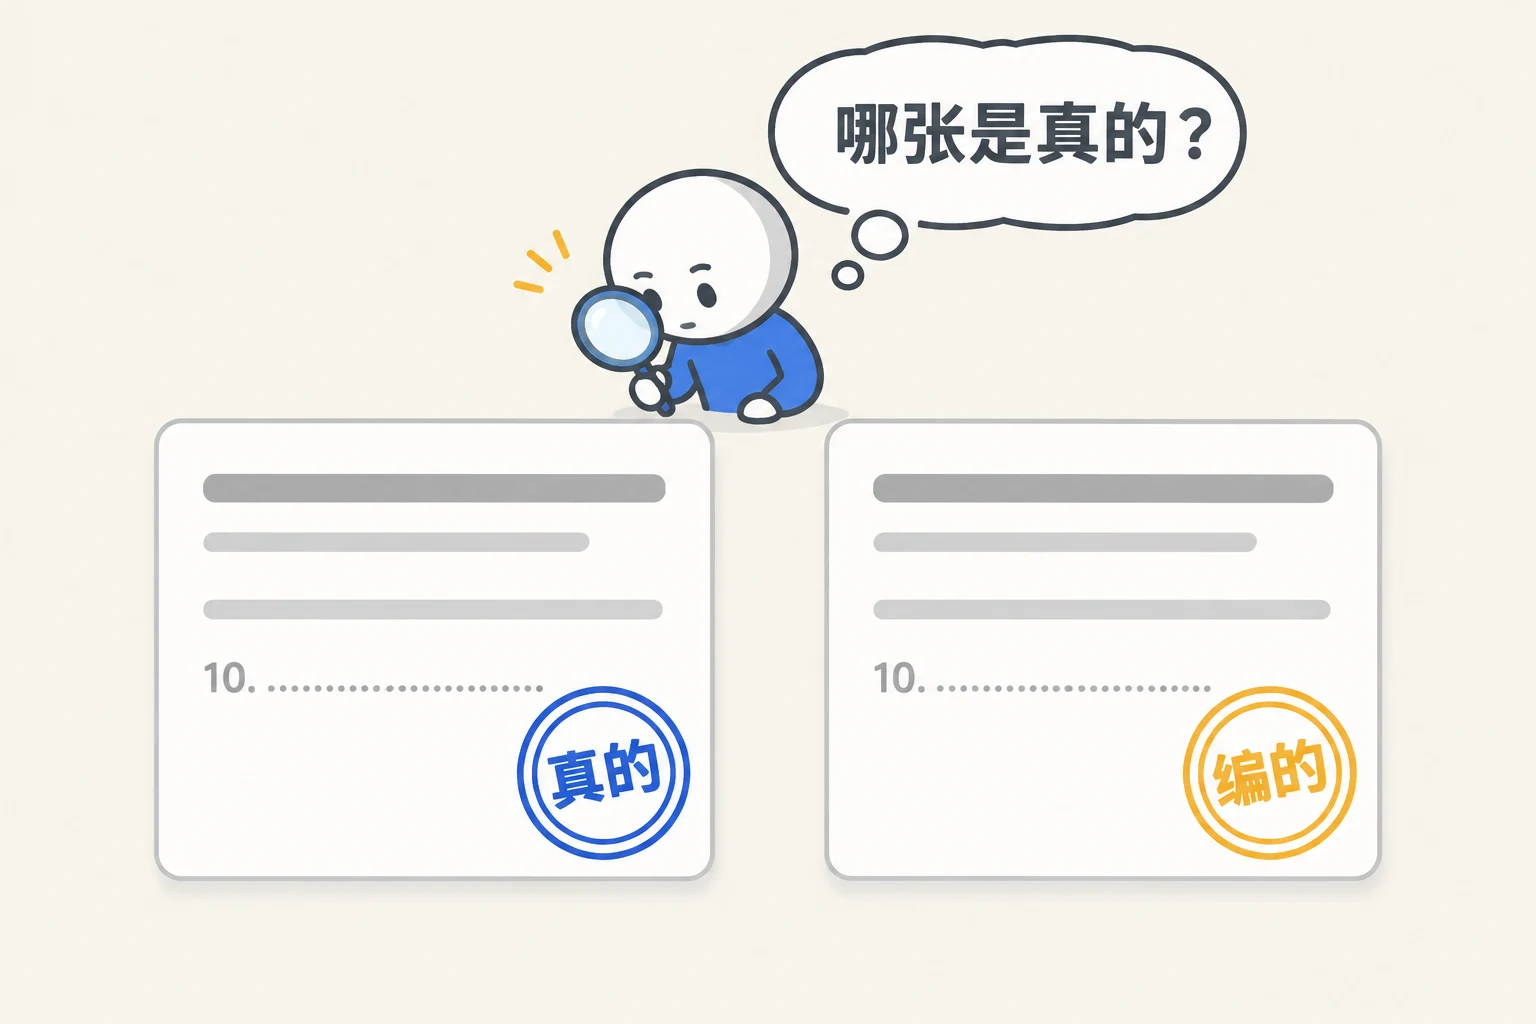
像不像,和真不真,是两回事。判断真假只有一个办法:回到原文去找。
现在的 AI,错在哪
先说一个好消息。我们拿一个现在常用的模型试了一次:"推荐 5 本讲家庭理财的中文书,写出书名、作者、出版社和出版年份。"它给的 5 本,我们逐本去查,作者、出版社、年份全部正确。
再问一个冷门的:让它找 3 篇 2022 年以后发表的、研究短视频对小学生注意力影响的中文期刊论文,要带 DOI。它没有编,而是直说"我现在无法核实,直接给你列,可能会把不存在的文献写进参考文献",然后教你去哪搜。
这次试的模型,在这种"明显该查证"的地方,说了不知道。可同一个回答里,它把你说的"2022 年以后"悄悄改成了"2023 年至今"。两次都这样改,口气还很肯定。
这几次试下来,比凭空编出一整本书更要当心的,是细节悄悄走了样。一个条件被改了,一个数字差了一位,一句推测被说成了事实。还有第 1 节讲过的那个测试:几个 AI 读同一批化验单,找"哪几项超出参考范围"几乎都对,一问"为什么异常",就有 AI 凭空多列了一项"升高",还顺着分析了原因。
最容易出错的七类内容
拿到回答,先看这几处:
| 内容 | 为什么容易错 | 怎么核 |
|---|---|---|
| 数字、统计、百分比 | 记不清就写一个"差不多"的 | 找到出处原文里的那个数;能算出来的,让它列出算式,你自己按一遍 |
| 原话、引语、"某某说过" | 常把意思相近的话安到别人头上 | 找到原文,看原话是不是这么说的 |
| 人名、书名、论文、判例、法条编号 | 格式好编,真假难辨 | 搜标题;论文把 DOI 放进 doi.org 打开,看跳出来的是不是同一篇 |
| "第一""唯一""最大""首个" | 极端说法最难证实 | 能找到权威出处才用,找不到就删 |
| 最近发生的事、价格、政策 | 它学的资料有截止日期 | 看官方公告或当天的来源 |
| 链接、网址 | 可能拼出一个不存在的网址 | 点开看,内容对不对得上 |
| 原因、推测、"因为……所以……" | 把可能说成一定 | 让它标明哪些是推测 |
怎么问,它编得少
一、给它说"不知道"的出口。它最容易编的时候,是你让它"必须给出"的时候:你要 3 篇论文,它就凑 3 篇。换个说法:
只列你确定真实存在的。每一项后面标上你的把握:确定 / 不太确定。不太确定的那一项留空,不要补一个看起来像的。找不到就直说找不到。
二、事实和推测分开标。尤其是分析数据、解读报告、判断原因的时候:
回答里,把"材料里直接写着的"和"你推测的"分开标出来。推测的部分,写明你是根据什么推的。
三、有材料,就只照材料答,并附原文。第 4 节讲过,这是最有效的一招:它不再靠记忆,而是照着你给的东西说,每句都能对回原文。
四、要最新的信息,让它联网并给出处。价格、政策、新闻这类会变的东西,别让它凭记忆答。开联网搜索,要它每条附上链接,你点开看。
五、别给它压力。"我明天就要交,你一定要给我三个数据支撑",它就一定会给你三个。把"一定要"改成"找得到就给,找不到就说"。
提示词库里这两条,都是先把"不许猜"写进提示词里:
- 看懂化验单:只让它找,不让它猜:逐项列出超出参考范围的指标,术语讲成人话,再列出该问医生的问题;只找,不猜病因
- 写商品详情,不编参数:拿不准的参数和功效标出来让你确认,不替你编
拿到回答,怎么核
别问同一个 AI"你确定吗"。它常常只会再确认一遍,或者换个说法把错的再说一遍。它不是在查,是在回答你的问题。
真正的核实,是回到原文:
- 有出处的,打开出处。链接点开、书名搜一下、论文找到原文、法条翻到那一条。看原文里是不是真有这句话、这个数。
- 重要的数字和原话,一个个对。不用全核,挑结论所依赖的那几个。
- 拿不准的,换一个来源交叉看。另一个搜索引擎、官方网站、另一个 AI 都行,但最后要落到原始出处上。
一份 AI 帮你做好的东西,比如报告、文章、方案,交出去之前,可以让它先反向检查一遍,把要核的东西挑出来给你:
请反向检查这份成品里的事实、数字、日期、名称和新增信息,逐项标记为:
A. 我给的原始资料里直接写着的
B. 能从原始资料明确推出来的
C. 你补充的,或者目前找不到来源的
C 类的内容不要猜,删掉或改成"待确认"。最后列出仍需要我亲自核对的项目。
它标的是线索,不是结论。A 类也要抽几条对一对,C 类每条都要过。
核多细:看错了的代价
不是每句话都要核。按错了会怎样来定:
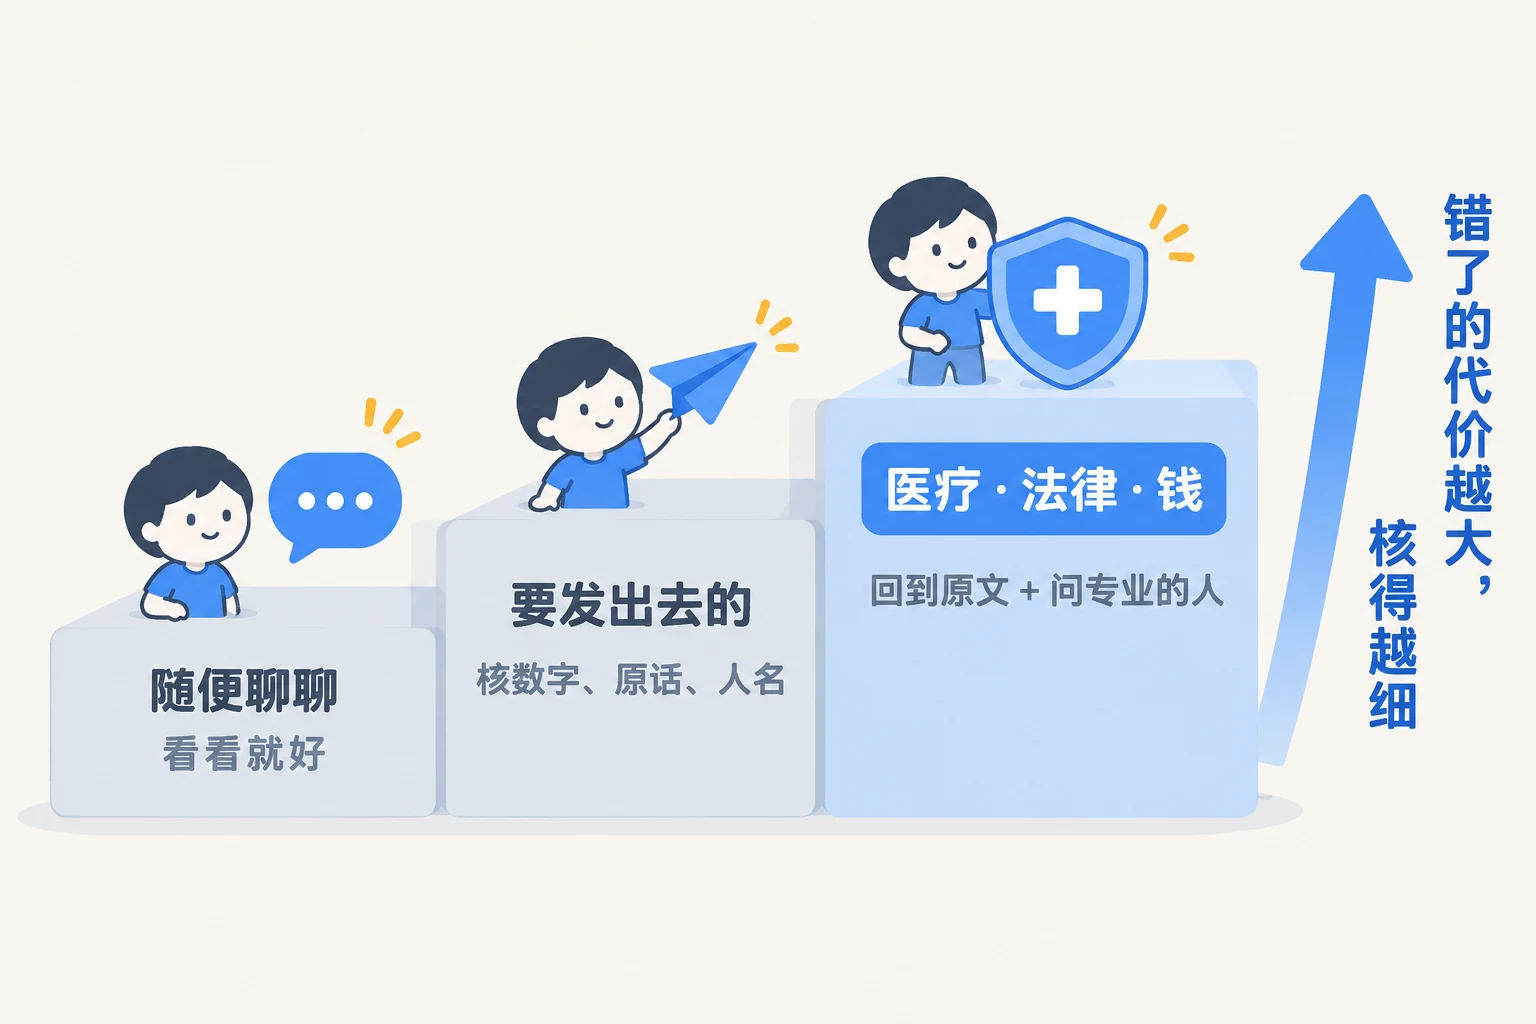
- 随便聊聊、找找思路:看看就好,觉得不对再问。
- 要发出去、交上去的:文章、报告、给客户的邮件,核其中的数字、原话、人名和"第一""最"。
- 医疗、法律、钱:体检结果、合同条款、投资决定,回到原文,并问真正的医生、律师、专业的人。AI 帮你把问题理清楚、把要问的写下来,拍板的不是它。
几个让人放松警惕的错觉
格式越整齐、口气越肯定,越可信。格式和口气说明不了真假:编出来的东西,格式一样整齐,口气一样肯定。判断真假靠原文,不靠样子。
- 联网了、给了链接,就不用核了。链接可能是真的,但页面上写的和它说的对不上。要点开看。
- 只核它自己标"不确定"的。它标"确定"的也可能错,比如那个被悄悄改成"2023 年"的条件。
- 第 7 节它挑出的毛病,直接当结论。唱反调挑出来的,是待查的疑点,要在这里一样核过。
再进一步:给老手的几点
- 让它先摘原文,再下结论。"先把支持这个结论的原文摘出来,再说结论",摘不出来的结论,就是它自己补的。
- 多份材料,让它找矛盾。几份报告、几篇文章说法不一样的地方,往往就是有一方错了的地方。
- 核引用,看的是"原文是否支持这句话",不只是"这篇文章存不存在"。真实存在的论文,也可能被安上它没说过的结论。
- 会动手干活的 AI 也会"说做完了"。让它交文件、改表格,交回来先打开看:文件在不在、改没改、数对不对。它说"已完成",不等于完成了。
- 把核对写进习惯。在自定义指令里写"不确定的信息标出来,不要补一个看起来合理的",每次对话都生效(第 13 节)。
记住这一句
像不像和真不真是两回事。给它说"不知道"的出口,让它分清事实和推测;数字、原话、名字、"第一"和最新的事,回到原文去核;错了的代价越大,核得越细。